המודל טוב בדיוק כמו הדאטה שהוא מקבל
בוט שעונה לא נכון כמעט אף פעם לא נכשל בגלל המודל. הוא נכשל כי הוא לא מצא את הקטע הנכון: מסמך סרוק שלא נקרא, טבלה שנחתכה באמצע, תמונה בלי תיאור, או אינדקס שלא התעדכן מאז שהאתר השתנה.
לכן אנחנו לא סומכים על האינדוקס המובנה של הכלים. אנחנו מתכננים את האינדקס בעצמנו, לפי סוג הדאטה ולפי השאלות שהמשתמשים באמת שואלים, ובודקים אותו לפני שהבוט עולה לאוויר.
כל סוג מידע, גם מה שקשה לקרוא
מסמכים סרוקים ו-PDF
Document Intelligence לטקסט, מבנה וטבלאות, ומודל ראייה כשהקריאות ירודה.
תמונות
צילומים, לוחיות זיהוי, צילומי מסך ותרשימים, עם OCR ותיאור שמאפשר לחפש בהם.
כתב יד
טפסים וחשבוניות בכתב יד, בעברית ובאנגלית, לצד טקסט מודפס.
טבלאות ונתונים
טבלאות שלא נחתכות באמצע, ונתונים מובנים מ-CRM ו-ERP.
אתרים ומערכות תוכן
סריקה של אתר קיים ומערכת תוכן כמו Umbraco, עם עדכון יחד עם האתר.
SharePoint ו-Microsoft 365
ספריות מסמכים, עם Security Trimming לפי הרשאות המשתמש.
ספרות טכנית
מדריכים ומפרטים של מאות עמודים, עם ציטוט מסמך, פרק ועמוד.
שיחות וידע מצטבר
היסטוריית פניות ושיחות שהופכת לידע לשאלה הבאה.
שישה שלבים מהדאטה הגולמי ועד תשובה עם מקור
- 1
מיפוי מקורות ושאלות
אילו מקורות, מי רשאי לראות מה, ואילו שאלות המשתמשים באמת שואלים.
- 2
חילוץ והבנה
OCR, כתב יד, טבלאות ותמונות הופכים לטקסט ומבנה, כולל מטא-דאטה של מקור, תאריך והרשאה.
- 3
חלוקה חכמה (Chunking)
חלוקה לפי מבנה המסמך, לא לפי מספר תווים, כדי ששום טבלה או סעיף לא ייחתכו.
- 4
Embeddings ואינדקס וקטורי
וקטורים ב-Azure AI Search, בשילוב חיפוש מילולי ומילים נרדפות, מותאם לעברית.
- 5
אחזור, הרשאות ומקור
חיפוש היברידי, Security Trimming לפי משתמש, וציטוט של הקטע שממנו נבנתה התשובה.
- 6
עדכון ובדיקה
אינדוקס מתעדכן עם המקורות, בדיקת איכות לפני עלייה, ולולאת שיפור על שאלות שלא נענו.
מה אינדקסנו, ואיפה זה רץ
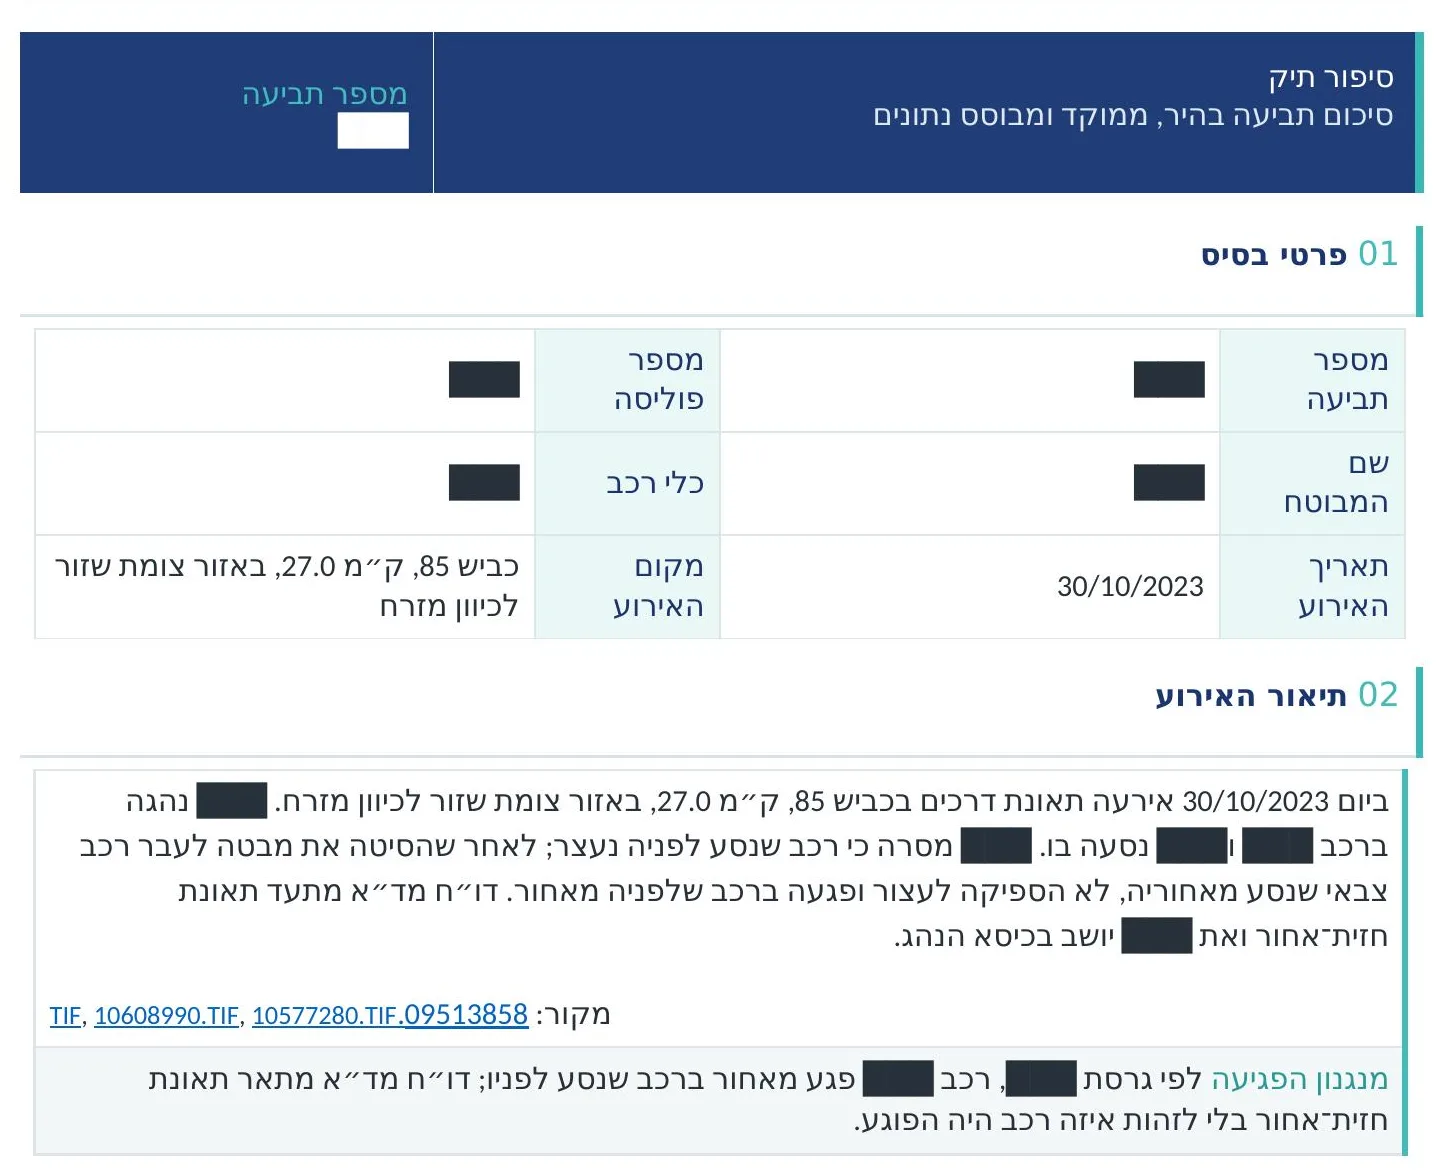
מאות מסמכים לתיק אחד
אינדוקס: סריקות, דוחות רפואיים, פוליסות ותכתובותכל קביעה בדוח מקושרת למסמך המקור, והאינדקס מתעדכן בכל מסמך חדש.
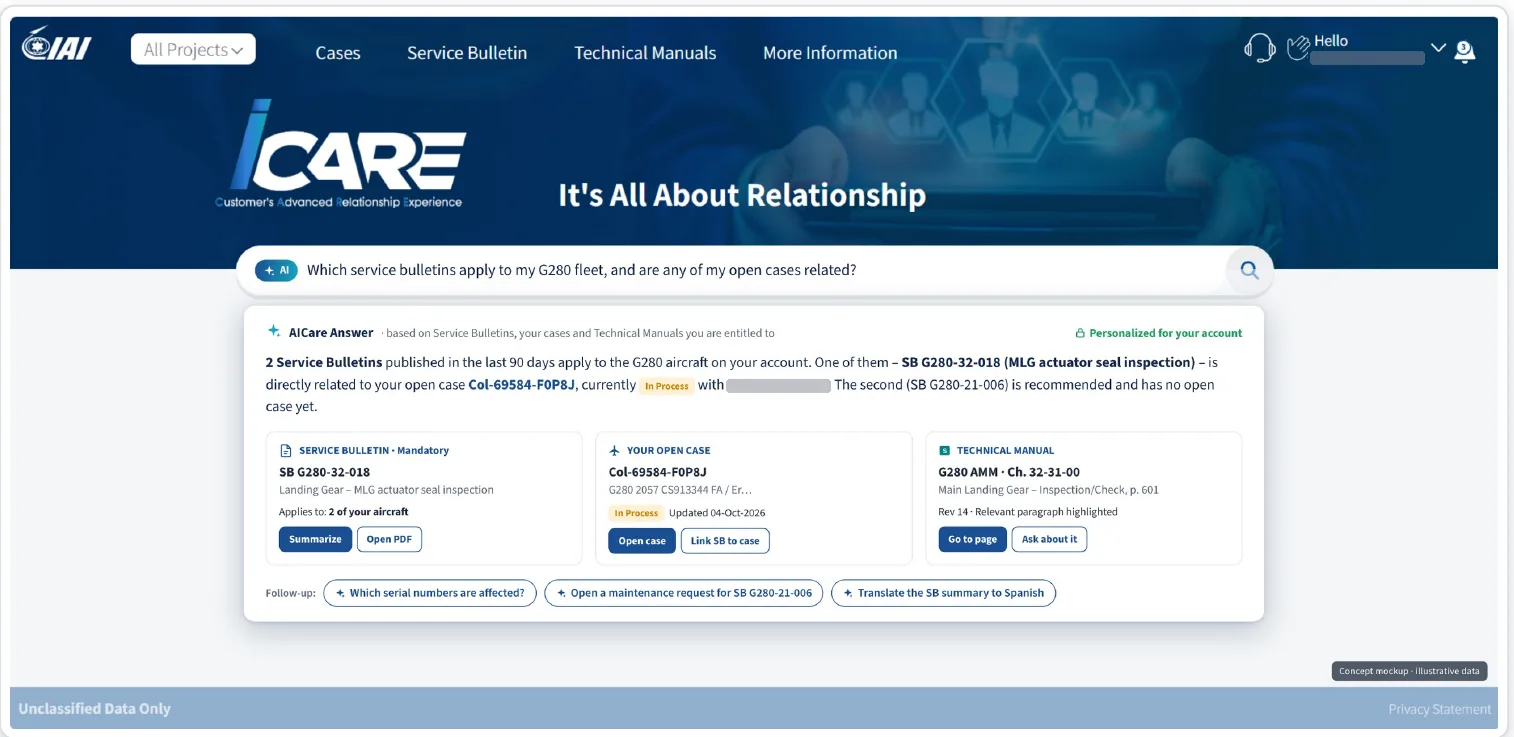
ספרות טכנית של מטוסים
אינדוקס: AFM, AMM ו-Service Bulletins, עם Security Trimmingתשובה והשוואה בין מסמכים, עם ציטוט מסמך, פרק ועמוד.
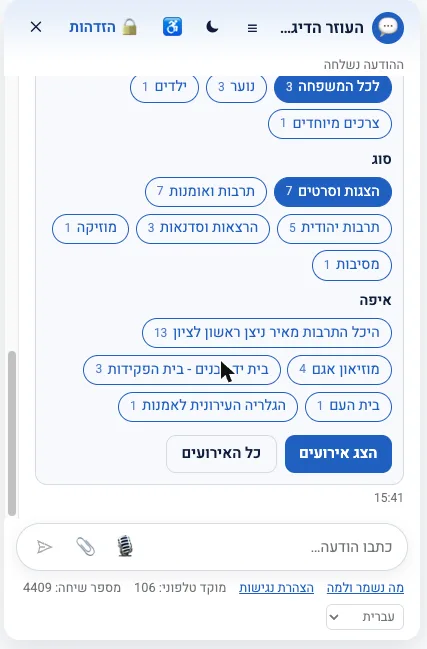
אתר, מסמכים ומערכת תוכן
אינדוקס: אתר העירייה, מסמכים ו-Umbracoהבוט עונה רק מתוכן מאונדקס, ושאלות שלא נענו הופכות למשימות לצוות התוכן.
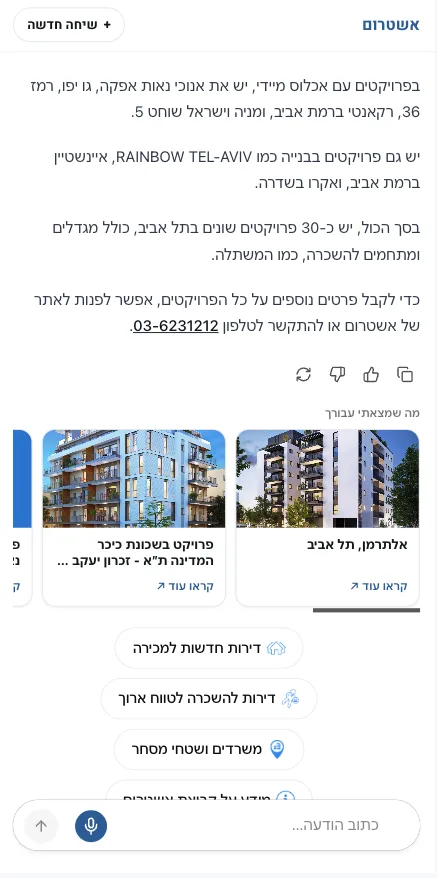
אתר שלם הפך לבסיס ידע
אינדוקס: עמודי פרויקטים, נכסים, מפרטים ותמונותחיפוש בשפה טבעית ובקול, עם כרטיסי פרויקטים ותמונות מתוך האתר.
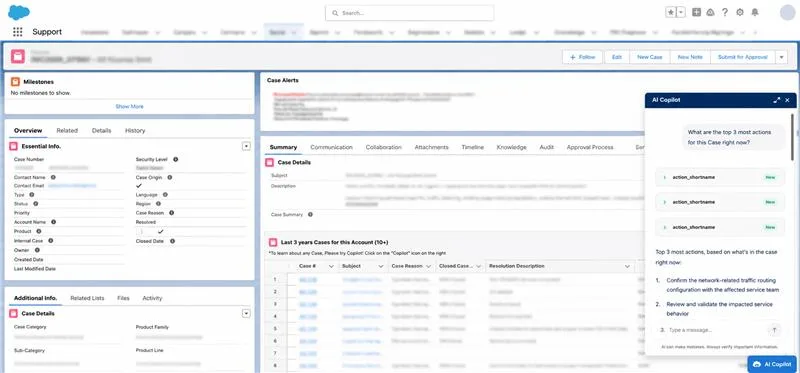
ידע של צוות שירות
אינדוקס: מקרים שנפתרו, לוגים, תהליכים ומאגר ידעהמלצות לפי הקשר הקריאה, בתוך ההרשאות של Salesforce.
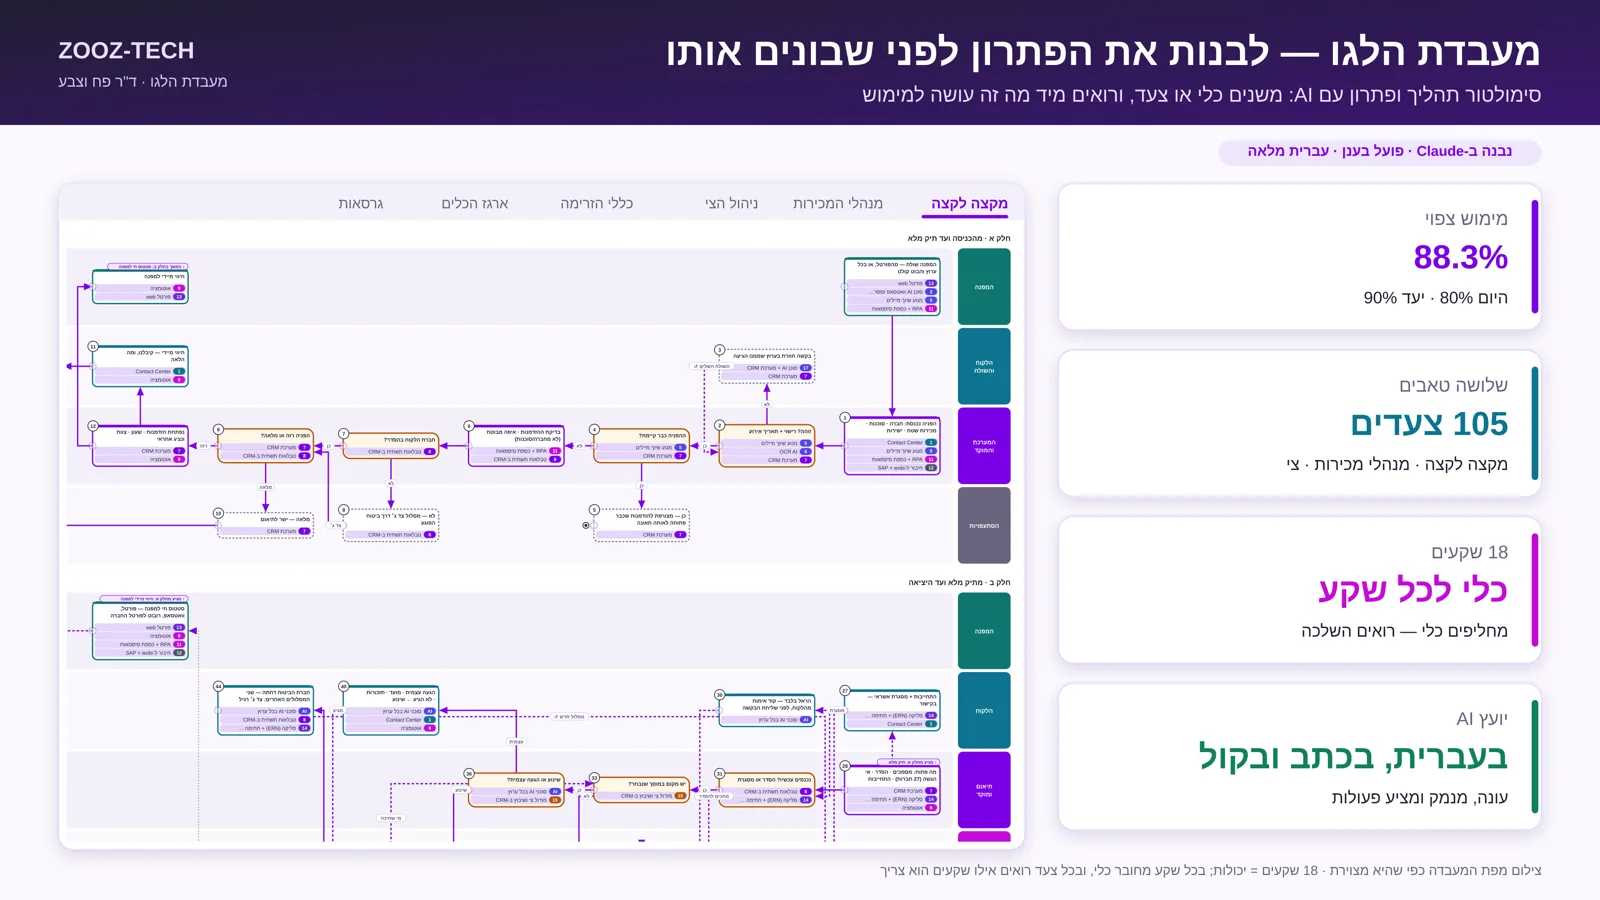
חומרי פרויקט שלם
אינדוקס: Word, PDF, PowerPoint ו-Excel, בחיפוש מותאם לעבריתיועץ AI שעונה מתוך כל חומרי הפרויקט ומציין מקור בכל תשובה.
שאלות נפוצות על RAG ומאגרים וקטוריים
מה זה RAG?
RAG (Retrieval-Augmented Generation) היא שיטה שבה המודל לא עונה מהזיכרון שלו, אלא קודם מאחזר קטעים רלוונטיים מהדאטה של הארגון, ורק אז מנסח תשובה מתוכם, עם מקור.
מה זה מאגר מידע וקטורי (Vector Database)?
מאגר ששומר כל קטע מידע גם כווקטור מספרי שמייצג את המשמעות שלו, כך שאפשר למצוא תשובה גם כשהשאלה מנוסחת במילים אחרות מהמסמך. אצלנו Azure AI Search משמש מאגר וקטורי והיברידי בו זמנית.
אפשר לאנדקס תמונות ומסמכים סרוקים?
כן. מסמכים סרוקים, צילומים וכתב יד עוברים OCR, ניתוח מבנה ותיאור, ונכנסים לאינדקס כמו כל טקסט אחר. כך אפשר לשאול גם על מה שכתוב בתוך תמונה.
מה לגבי הרשאות ואבטחה?
כל קטע באינדקס נושא את ההרשאה של המקור שלו, וכל משתמש מקבל תשובה רק ממה שמותר לו לראות. הדאטה נשאר ב-Azure של הארגון.
למה לא להשתמש באינדוקס המובנה של Copilot Studio?
האינדוקס המובנה נוח להתחלה, אבל לא שולט בחלוקה, בעברית, בטבלאות ובתמונות. אינדקס מתוכנן ב-Azure AI Search נותן תשובות מדויקות יותר, ומשרת כמה בוטים וסוכנים בבת אחת.
יש לכם הרבה ידע ואף אחד לא מוצא אותו?
נמפה את הדאטה שלכם ונראה מה AI יכול לעשות איתו.